专家路由更均匀了,decode 却几乎没变快。遇到这种结果,继续把更新间隔从 1000 拉到 4000,或直接加并发,可能再花一轮加载、预热,仍然解释不了收益卡在哪里。
在 DeepSeek-V4-Flash、Ascend 910C 上,我们确实测到过很不一样的结果:普通 decode 实际 batch=80,换布局后 forward 仅快约 0.65%;DSpark 实际 batch=256,三轮 target verify 快了 7.53%~8.61%;最后 P、D 同时开启 EPLB,AISBench 稳态输出吞吐提高 4.72%。
这三组数字的计时边界不同。前两组固定一次计算来看布局,最后一组把持续统计、周期迁移、投机解码和 PD 供给都放回服务,再由客户端计时。下面沿这几个实验说明局部收益怎样传到整套系统。
一、先决定要证明哪一层收益
我们先固定计算状态,确认布局本身有没有用;再加入周期更新,看省下的时间够不够搬权重;最后撤掉诊断代码,做干净的 OFF/ON 服务对照。
表格可左右滑动 →
| 实验 | 保持什么一致 | 主要观察 |
|---|---|---|
| 固定状态 A→B→A | 输入、batch、上下文、KV、图路径 | 布局改变后的普通 forward 或 target verify 耗时 |
| 周期策略 | 初始布局、负载、统计方式 | 普通计算收益、真实 update 成本、延迟尖峰 |
| 干净 OFF/ON | 模型、硬件、容量、负载和客户端 | 稳态输出吞吐、TTFT、TPOT、ITL、E2E、失败数 |
固定状态里的 A 是原布局。A、B 通常都保留统计,只冻结周期迁移,显式触发一次更新来得到 B。这能隔离布局变化,却没有测到统计本身相对完全关闭统计的成本。
PD 还多一个选择:固定 P、只改 D,才能研究 D 的独立作用;两边都开启,则评价整个部署方案。后面最终服务表属于后者。
DSpark 的 target verify、完整投机迭代、客户端 TPOT 也分别命名,避免一律叫“decode 一步”后混掉分母。
二、固定一次真实计算,再做 A→update→B→restore A
在线更新前后的 batch、上下文、请求组成都在变,直接截两段 forward 比较,很难知道快的是布局还是负载。
固定状态实验先用独立流量积累有效路由、生成候选布局,再从真实负载中保存代表性输入:token、positions、seq_lens、KV 槽位与内容、图档位。DSpark 还固定这次 verify 的候选 token 和宽度。
评估按下面的顺序执行,最后恢复原布局:
flowchart LR
    A[原布局 A:预热与计时] --> U[一次真实 update]
    U --> B[新布局 B:相同状态计时]
    B --> R[恢复布局 A]
    R --> C[相同状态再次计时]
同一批输入对象还不够,因为重放也会写 KV。观察器要保证各次执行读到等价状态,并核对输入指纹、逻辑专家选择、输出值。换布局后,旧图继续读取原权重地址;恢复 A 后,物理路由也应回到原分布。诊断重放则排除在学习窗口之外,避免同一份输入被反复用于规划。
NPU Event 包住实际 eager 执行或图回放。每次先取 16 个 rank 的最大跨度,再对同一块样本求中位数。这样保留慢端等待;把 16 份相加会重复计入并行工作,只看 rank 0 又可能漏掉慢端。
首步在测试前约定单列。普通 decode 每块重放 20 次,剩余 19 次取中位数;DSpark 每块先预热 3 次、测 30 次,第一个测量值单列,其余 29 次汇总。所有原始值都保留,profile 另外取短窗口。
恢复 A 用来识别顺序漂移:频率、温度、缓存状态随时间变化,后测的 B 可能因此变快;若恢复后 A 也同幅度变快,就得重看归因。同一状态的多次重放仍是相关样本,要覆盖业务分布,还需要不同请求和上下文。
三、batch 要读实际值,均衡度要和时间一起看
客户端并发 256,不保证 D 每轮都有 256 请求可跑。P 供给、PD 传输、到达节奏、KV 准入都影响实际 batch。attention DP16 还需要按 rank 记录请求数和图桶大小。
有一轮普通 decode,客户端并发就是 256,但保存状态时全局实际 batch 为 240。各 rank 有 14~16 个请求,都进大小为 16 的图桶,总共分配 256 个图槽。这个实验应叫 batch=240,256 是图容量。
表格可左右滑动 →
| 普通 decode 固定批次 | 原布局 A | 更新布局 B | 恢复 A | B 相对首次 A |
|---|---|---|---|---|
| 实际 batch=80,ms | 39.727 | 39.468 | 39.843 | -0.65% |
| 实际 batch=240,ms | 43.794 | 43.004 | 43.902 | -1.80% |
表中各行都只在自己的 A/B/A 内固定状态,行与行之间并非只改 batch,不能当作严格缩放曲线。小 batch 的局部结果也就不足以概括其他 decode 形态。
batch=80 那轮,43 层平均 rank 负载均值/max 从 43.86% 升到 59.28%,40 层最忙 rank 的路由数下降,但 forward 仅快约 0.65%。
短 trace 给出了线索:采样 rank 的稳定图主体约 37.5 ms,Attention 子层约 19 ms,专家 GMM 累计约 4 ms,整条 routed 路径在更新后没有明显变短。路由均衡改善没有等比例落到关键路径上,图桶、活跃专家、GMM、权重读取和通信等待都还可能影响结果。
这些区间有包含、重叠关系,不能相加成整步时间。路由还需要剔除 padding,见DeepEP 有效路由一文。原来已很均衡的样本也保留在结果中,它们本就没有多少优化空间,删掉会抬高收益。
四、DSpark 先测 verify,再补完整迭代的分母
DSpark 让 target 一轮处理更多行:gamma5、verify width6 时,全局 256 请求对应 1536 行 target verify,每 rank 16 请求对应 96 行。普通 decode 每请求一个新 token,计算形态已经不同。
用真实连续满批积累统计后,我们做了三轮固定 A/B/A。每轮保持候选、位置、KV 状态一致,下表只计 target verify:
表格可左右滑动 →
| 实际请求 batch=256 | A,ms | B,ms | 恢复 A,ms | B 耗时减少 |
|---|---|---|---|---|
| 第 1 轮 | 87.214 | 79.706 | 86.021 | 8.61% |
| 第 2 轮 | 87.695 | 81.091 | 86.014 | 7.53% |
| 第 3 轮 | 86.766 | 79.985 | 87.394 | 7.82% |
第一轮路由均衡度约从 0.453 提升至 0.765。三轮 B 都比前后两段 A 快,恢复 A 的漂移也列在表内。这组计算形态中,布局调整确实减少了 target verify 耗时。
完整投机迭代还包含 draft、接受提交、调度,每轮提交的 token 数也可能变化,需要另看 AL、严格接受率。该实验还留下这份原生计数窗口:
表格可左右滑动 →
| 负载点 | AL,含 bonus | 接受的 draft / 实际 verify 候选槽 | 严格接受率 | gamma / verify |
|---|---|---|---|---|
| C128 | 5.5352 | 19,633 / 21,645 | 90.70% | 5 / 6 |
| C256 | 5.2242 | 17,746 / 21,005 | 84.48% | 5 / 6 |
计数来自各 DP rank 末尾的原生窗口,包含排空,AL 采用请求结束截断前的提交长度。它既没与三轮 A/B 逐一对应,也不是最终 AIS 稳态窗口,因此只能描述这批负载的投机行为,不能用来解释 EPLB 带来的 batch 差异。
这里的严格接受率用实际接受前缀、实际候选槽计数;只有 AL 时,(AL-1)/gamma 仍不能替代它。target verify 快 8%,并没有测出 draft、提交也快 8%,完整迭代还得用同一窗口的输出和总耗时来算。
五、先问搬运能否回本,再调 I 和 W
布局已能省下一次计算的时间,接下来估算它能否支付周期 update:
每步净节省 ≈ 普通计算的节省
           − 一次更新带来的额外时间 / 更新间隔
           − 相对真正 OFF 新增的持续统计开销
这个预算假设收益在整个更新间隔中持续,而且节省、成本都用相同的迭代单位。DSpark 的一次 target verify 不等于一个最终输出 token,I 也不是毫秒数。
batch=240 的例子每步约省 0.790 ms,首次完整 update 的最慢 rank 墙钟约 1535 ms,按此约需 1943 步回本。它只能作预算参考:首次 update 包含首次 dump,恢复 A 时又没做完整重平衡规划,两种成本都不能替代稳定热态 update。
更新同时记整段墙钟和分阶段设备时间。load 做 NZ→ND,迁移有 P2P、等待、本地拷贝,store 做 ND→NZ、写回;CPU 提交 send/recv 的几毫秒只覆盖提交。设备 Event 延后读取,避免逐段插全设备同步而改变原流程。
要算“转换占 forward 百分比”,先在每 rank 内把同窗阶段累计、正常 forward 累计配成对,再汇总。16 份阶段时间不能除以一份 forward,重叠区间也不能直接相加成阻塞比例。内置 update 日志还要核起止点,最终影响交给客户端结果验证。
I 控制多久检查一次,W 决定保存多少记录;该版正窗口配置要求 W≤I。先固定 W1000 比 I1000/I4000,再固定 I4000 比 W1000/W4000,可以减少组合。W 变小只缩短保留历史,不代表统计仅在最后 W 步开启。
已有 non-spec 诊断从学到的 B 布局开始:冻结后热尾段吞吐 5608.78 token/s,I4000/W1000 为 5556.02,I4000/W4000 为 5566.06,持续更新没有带来额外收益。这是单次顺序诊断,统计一直开启,不能标作干净 OFF。对这次负载,减少搬运频率也没有解决布局本身收益有限的问题。
策略比较还依赖窗口里确实是 target。零记录与窗口覆盖中的 draft 空记录会挤掉 W 内的有效历史,参数没变,实际保留的时间范围却已变了。
六、稳态 OFF/ON 要把容量、预热和窗口一起对齐
固定计算有收益后,我们撤掉诊断 hook,再对齐完整服务:模型、代码、设备与并行配置,冗余预算和初始布局,DSpark、实际 KV 容量,以及实际输入输出、采样、缓存、并发、速率、客户端计时。
相同内存比例不保证相同 KV 容量,EPLB 资源可能改变自动分配结果,得看启动记录。提高并发前,也要按本地序列数、完整上下文、页对齐核容量,再查图档位是否覆盖 batch。
预热要经过模型、图和这次测的迁移路径。我们的 PD/MF 环境重启后先做两轮短测、再长预热,确认 ON 已经更新过;这个轮数是当时环境的经验。若服务健康、负载仍在跑,只是采集出错,则先修原数据,避免再付一次模型加载成本。
那次 AISBench 3.1.0 的 StablePerfMetricCalculator 从第二次达到最大并发选到最后一次达到,再纳入 start_time 位于区间内的请求,见固定版本源码。总请求数要撑得起这个区间,若只发与并发数相同的一批请求,往往形不成所需稳态。
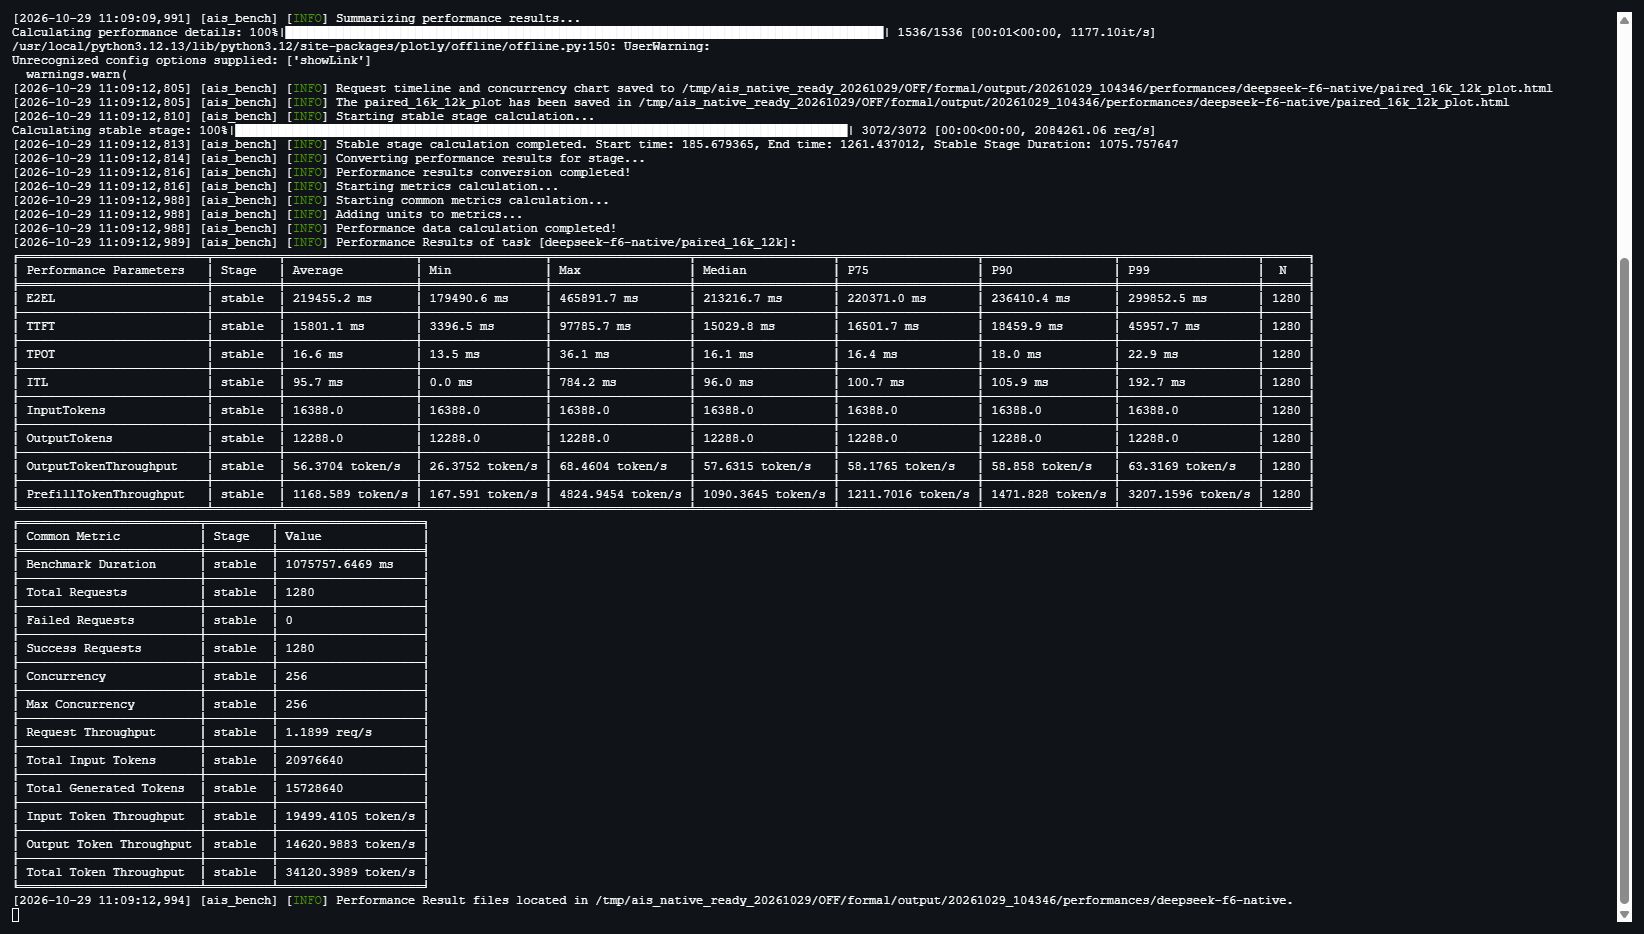
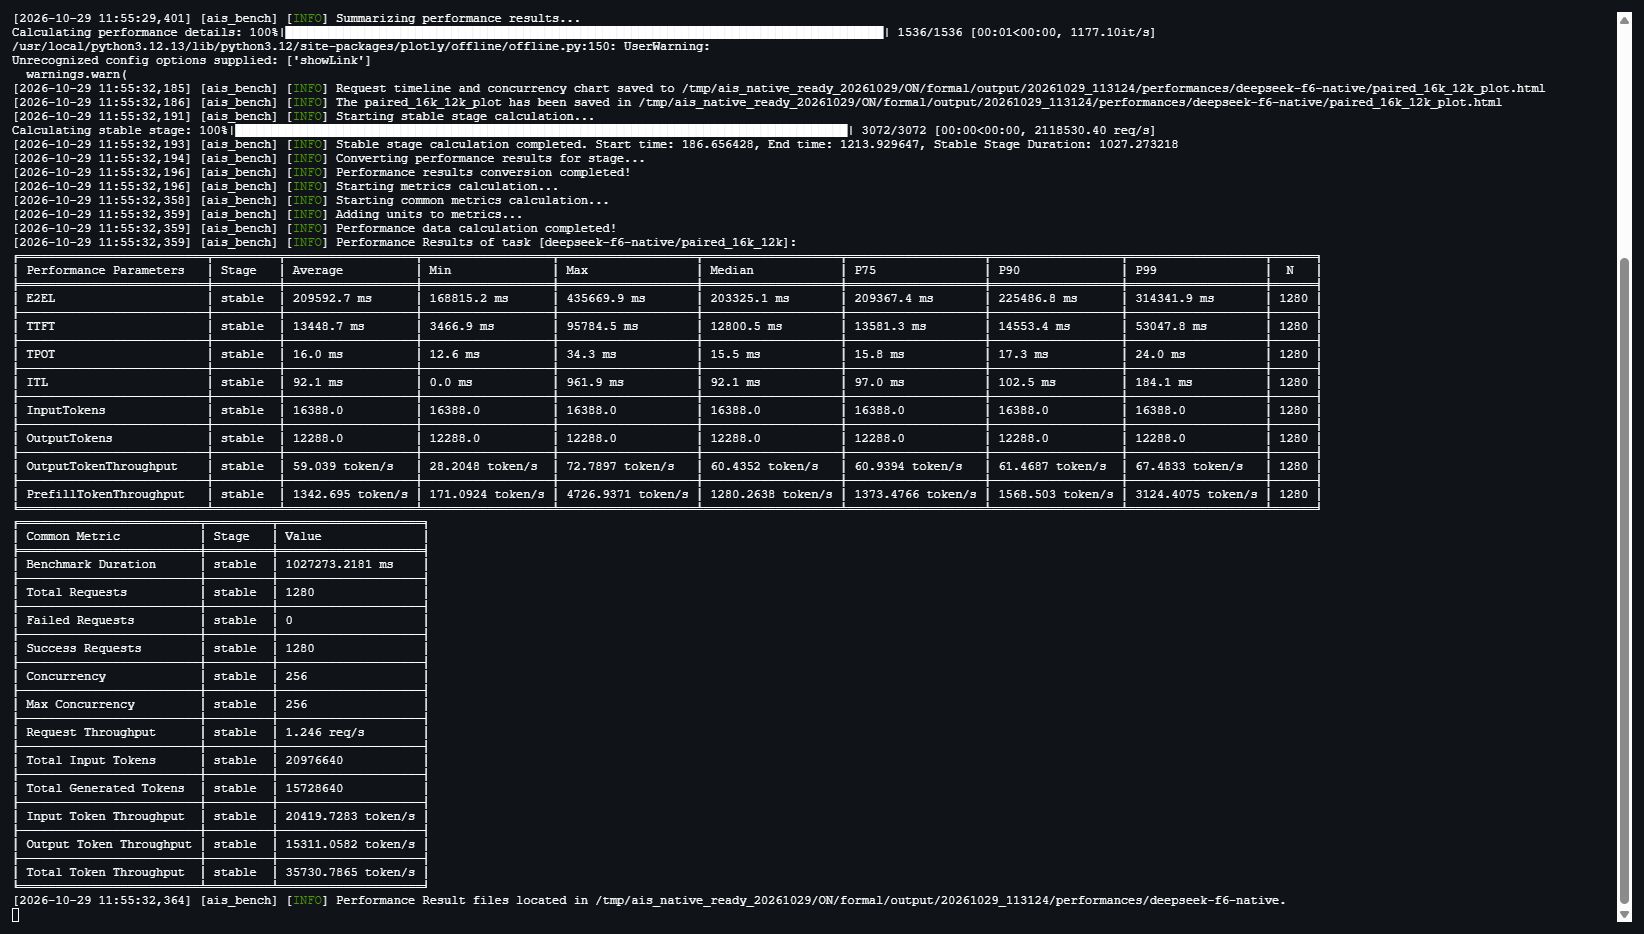
正式配对使用 f6ad2f4f。P、D 各 16 个 Ascend 910C 逻辑设备,TP16/EP16/attention DP16,两端各 16 个冗余专家,DSpark 5/6。ON 为 P I50/W50、D I4000/W1000;OFF/ON 的实际 KV 上限均为 P369024、D524288。合成复制负载输入 16,388 token、固定输出 12,288 token,1536 请求、闭环并发 256,关闭前缀缓存。
表格可左右滑动 →
| AIS 原生稳态指标 | OFF | ON |
|---|---|---|
| 正式成功 / 失败 | 1536 / 0 | 1536 / 0 |
| 稳态样本 / 区间时长 | 1280 / 1075.76 s | 1280 / 1027.27 s |
| 输出吞吐,token/s | 14,620.99 | 15,311.06 |
| 平均 TTFT,s | 15.80 | 13.45 |
| 平均 TPOT,ms | 16.57 | 15.96 |
| 平均 ITL,ms | 95.68 | 92.09 |
| 平均 E2E,s | 219.46 | 209.59 |
| AL 原生 gauge,采样均值 | 5.7666 | 5.7512 |
| 严格全局 draft 接受率 | NOT_OBSERVED | NOT_OBSERVED |
整套配对输出吞吐提高 4.72%,平均 TPOT 降低 3.69%,迁移影响已经在服务结果内。稳态中 D 更新 3 次、P 更新 11 次,原生日志每轮最慢 rank 耗时的均值约为 714 ms、680 ms。两端一起开启,收益也只能先归于组合方案。
这张表没有实际 proposed token 分母,接受率是原生 gauge:OFF/ON 采样均值 95.33%/95.02%,范围 78.53%~100%/80.09%~100%,AL 范围 4.9266~6/5.0047~6。rank/time 未加权采样无法给出全局严格接受率,与前一节实际计数的口径不同。
吞吐、平均值改善时,长尾却变差:P99 TTFT 从 45.96 s 到 53.05 s,P99 TPOT 从 22.88 ms 到 23.96 ms,P99 E2E 从 299.85 s 到 314.34 s。这是保留方案时一起权衡的代价。TTFT 还含排队、Prefill、PD 交接,也不能替代一次 prefill forward。
七、下一轮实验,用上一层的结果决定
固定状态没有收益,就先追实际 batch、有效路由和 MoE 关键路径;改 I 只能减少搬运次数,解释不了一次计算为何没变快。forward 已有收益,再用热态 update 和负载漂移定周期,最后确认干净稳态配对。每一层的结果决定下一轮值得花在哪。
要拆 D 的独立贡献,下一组应固定 P、只比较 D OFF/ON;要决定整套部署是否保留,则重复完整配对,并记录回到基线后的变化。局部 trace 与不利负载点都留着,它们能解释服务结果的适用范围。
复核材料也按这些边界对应:固定输入与 Event、前后有效路由、更新阶段、同窗接受计数、实际 batch/context 分布、客户端结果和原始终端输出。这样才查得到省下的时间发生在哪里,又被哪里抵消。
版本与数据
实验来自 2026-10-28~29 的 f6ad2f4f922d0df111dc66153f543a453267455c,模型为 DeepSeek-V4-Flash-0731 W8A8,历史实现含 TP 复用、draft 隔离。普通 decode、DSpark 固定计算、周期策略、AIS 稳态各自保留独立窗口。
证据说明交代配置、来源校验值和口径,固定计算结果、逐次 Event CSV可重算布局收益,原生稳态结果含请求指标、接受率采样、更新次数,周期策略对照含冻结布局和两种 I/W 的热尾段数据。
当时真实 AISBench 终端截图为 OFF、ON,对应 OFF CSV、ON CSV。客户端指标的算法见 AISBench whole、native、TPOT 和 ITL。
整服务吞吐提高、平均 TPOT 却变差时,可接着看平均 TPOT 变差了,吞吐却提高了:这两个指标为什么不矛盾?,其中使用另一组已公开 OFF/ON 数据分析流水线负载与延迟取舍。